Tips Mengoptimalkan GPU untuk AI Lokal, Cara Mempercepat Inferensi dan Menekan Beban Sistem

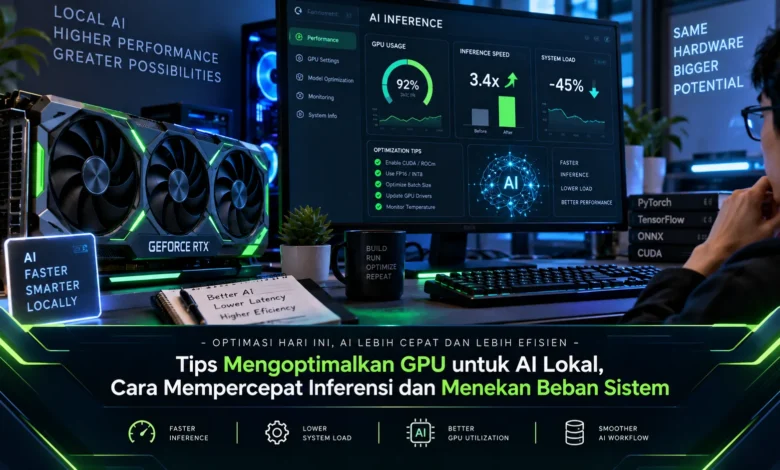
Menjalankan AI secara lokal semakin menarik karena pengguna dapat memproses model langsung melalui komputer sendiri tanpa selalu bergantung pada layanan cloud. Namun, performa AI lokal sangat dipengaruhi oleh kemampuan GPU, kapasitas VRAM, ukuran model, serta konfigurasi software yang digunakan. Dengan optimasi yang tepat, inferensi dapat berjalan lebih cepat sekaligus menjaga beban sistem tetap terkendali. Pendekatan ini semakin relevan dalam perkembangan TEKNOLOGI AI ketika model lokal mulai digunakan untuk berbagai kebutuhan produktivitas dan eksperimen.
Pahami Beban Model agar Inferensi Lokal Lebih Efisien
Langkah awal dalam mengoptimalkan GPU untuk AI lokal ialah mengetahui kebutuhan komputasi dari model yang digunakan. Masing masing model AI membutuhkan kapasitas memory serta kemampuan pemrosesan yang tidak sama, sehingga memilih model terbesar belum tentu memberikan pengalaman penggunaan terbaik. Model yang sesuai dengan kapasitas perangkat dapat membantu menghasilkan performa yang lebih nyaman untuk penggunaan sehari hari.
Kapasitas memory GPU perlu diperiksa sebelum model dimuat sebab model dan berbagai proses komputasi menggunakan memory secara bersamaan. Ketika model menghabiskan hampir semua VRAM, sistem dapat kehilangan ruang untuk menangani operasi tambahan. Melalui pemilihan model berdasarkan kemampuan perangkat, inferensi lokal dapat berjalan dengan penggunaan sumber daya yang lebih terkendali.
Kelola VRAM agar Inferensi Tetap Cepat dan Stabil
Memory GPU menjadi salah satu komponen utama ketika menjalankan AI lokal. Ketika model berhasil dimuat sepenuhnya pada GPU, inferensi biasanya dapat berjalan lebih efisien dibandingkan ketika terlalu banyak data harus berpindah antara GPU dan memory sistem.
Menghentikan software yang mengonsumsi memory grafis secara tidak penting bisa memberikan ruang memory tambahan bagi model. Program grafis, browser dengan banyak proses, permainan, dan aplikasi video mungkin mengambil kapasitas memory yang sebenarnya dapat digunakan model. Menjaga sebagian VRAM tetap tersedia membantu menjaga stabilitas saat workload membutuhkan alokasi tambahan. Pengaturan sederhana tersebut menjadi salah satu cara praktis mengoptimalkan TEKNOLOGI AI lokal dengan perangkat yang sudah tersedia.
Quantization Membantu Model Besar Berjalan Lebih Ringan
Pengurangan precision model merupakan strategi yang cukup efektif untuk menjalankan model AI secara lokal. Metode tersebut menyimpan parameter menggunakan format numerik yang lebih ringkas, sehingga kebutuhan memory dapat turun secara signifikan. Representasi bobot yang lebih ringkas dapat membuat model berukuran besar lebih mudah dijalankan pada GPU konsumen.
Pemilihan tingkat quantization tetap perlu disesuaikan dengan kebutuhan. Representasi dengan bit lebih sedikit dapat memberikan penghematan VRAM lebih besar, namun hasil inferensi tertentu mungkin mengalami penurunan kualitas. Karena itu, pengujian pada workload nyata menjadi langkah yang penting supaya konfigurasi akhir memberikan efisiensi tanpa mengorbankan hasil secara berlebihan.
Konfigurasi Batch dan Context Membantu Menjaga Efisiensi
Bukan hanya bobot model, jumlah informasi yang diproses dalam satu konteks dapat meningkatkan penggunaan memory. Context yang semakin panjang dapat membutuhkan kapasitas tambahan untuk menyimpan cache selama proses generasi. Jika kebutuhan penggunaan tidak memerlukan konteks sangat panjang, menggunakan batas context yang lebih realistis dapat mengurangi beban sistem.
Ukuran batch merupakan konfigurasi lain yang perlu disesuaikan. Jumlah batch yang melampaui kemampuan perangkat dapat meningkatkan konsumsi memory secara cepat, sedangkan ukuran yang sangat rendah dapat mengurangi efisiensi pemrosesan. Penyesuaian batch sebaiknya dilakukan sedikit demi sedikit sembari membandingkan respons model dan utilisasi GPU. Metode penyesuaian bertahap tersebut lebih efektif untuk menemukan konfigurasi optimal.
Optimalkan Software dan GPU Offloading untuk Mempercepat Inferensi
Performa AI lokal tidak hanya ditentukan oleh GPU. Framework, backend komputasi, driver, serta konfigurasi software memiliki peranan penting dalam menentukan efisiensi sistem. Runtime yang mendukung kemampuan komputasi perangkat secara tepat dapat mengurangi overhead dan mempercepat proses inferensi.
Pembagian workload antara GPU dan CPU dapat diatur berdasarkan sumber daya yang tersedia. Jika VRAM mencukupi, lebih banyak komponen model dapat ditempatkan pada GPU untuk mengurangi ketergantungan terhadap CPU. Jika VRAM terbatas, sebagian workload dapat dipindahkan ke RAM atau CPU, walaupun perpindahan data berpotensi mengurangi performa. Menemukan pembagian yang tepat berpotensi meningkatkan efisiensi tanpa memaksakan kapasitas GPU.
Pantau Suhu dan Utilisasi untuk Menemukan Bottleneck
Penyesuaian konfigurasi sebaiknya didasarkan pada hasil monitoring. Pemakaian kartu grafis, memory GPU, prosesor, memory sistem, suhu, dan throughput dapat dipantau selama workload berjalan. Informasi tersebut dapat memperlihatkan sumber hambatan performa.
Ketika aktivitas GPU rendah sedangkan penggunaan CPU mendekati batas, workload mungkin masih terlalu bergantung pada CPU. Ketika konsumsi VRAM sangat tinggi, pengguna dapat memeriksa kembali precision, panjang konteks, cache, serta model. Kondisi thermal yang kurang ideal dapat menyebabkan sistem menurunkan performa untuk menjaga perangkat. Dengan memahami bottleneck terlebih dahulu, penyesuaian dapat difokuskan pada sumber masalah sebenarnya.
Penutup
Optimalisasi AI lokal memerlukan penyesuaian antara kebutuhan model, memory GPU, software, serta spesifikasi perangkat. Pemilihan model realistis, manajemen VRAM, precision yang efisien, konfigurasi context, batch, serta pembagian workload dapat membantu mempercepat inferensi sekaligus mengurangi tekanan terhadap sistem.
Monitoring tetap menjadi bagian penting dari seluruh proses sebab konfigurasi terbaik dapat berbeda antara satu sistem dengan sistem lainnya. Kemajuan TEKNOLOGI kecerdasan buatan pada perangkat personal menjadikan efisiensi hardware sebagai faktor yang semakin penting. Dengan melakukan pengujian secara bertahap dan mencatat perubahan performa, pengguna dapat memperoleh pengalaman inferensi yang lebih responsif dengan perangkat yang sudah dimiliki. Pengguna dapat menguji konfigurasi satu per satu agar perubahan performa lebih mudah diukur.