Tips Menjalankan LLM Offline untuk Pemula, Cara Memilih Model AI Sesuai Kemampuan Laptop dan PC

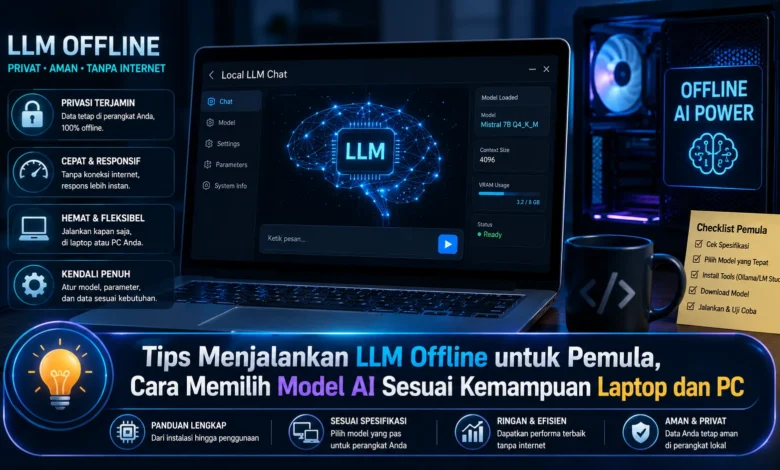
Menjalankan Large Language Model atau LLM langsung di laptop maupun PC kini semakin mudah dilakukan tanpa harus selalu mengandalkan layanan AI berbasis cloud. Bagi pemula, tantangan utamanya bukan sekadar memasang aplikasi, melainkan memilih model yang sesuai dengan kemampuan RAM, GPU, VRAM, prosesor, dan penyimpanan perangkat. Dengan memahami kebutuhan hardware dan karakter setiap model, TEKNOLOGI AI lokal dapat digunakan untuk menulis, merangkum dokumen, membantu pemrograman, hingga berbagai eksperimen secara lebih privat dan fleksibel.
Memahami Kemampuan Perangkat Menjadi Langkah Awal Menjalankan LLM Offline
Tahap awal sebelum menjalankan LLM offline adalah mengetahui kapasitas hardware yang tersedia. Kapasitas memori, kemampuan pemrosesan grafis, unit pemrosesan utama, serta ruang penyimpanan akan memengaruhi ukuran model yang nyaman dijalankan. Semakin tinggi kebutuhan komputasi LLM, biasanya kebutuhan memorinya ikut meningkat.
Jika baru mulai mencoba, model berukuran besar belum tentu menjadi pilihan terbaik. Model yang lebih ringan sering memberikan pengalaman awal yang lebih baik karena waktu respons dapat lebih cepat. Target yang ideal adalah keseimbangan antara kualitas dan performa, bukan memaksakan LLM yang melampaui kemampuan perangkat.
Kapasitas Memori Membantu Menentukan LLM yang Cocok Digunakan
Kapasitas memori komputer menjadi dua faktor penting ketika memilih LLM lokal. Memori sistem dapat digunakan untuk menampung model dan proses aplikasi, sementara VRAM berperan besar saat model diakselerasi kartu grafis. Jika memori tidak mencukupi, sistem dapat kesulitan menjalankan inferensi dengan nyaman.
Untuk menghindari masalah, pengguna sebaiknya memberikan cadangan memori bagi aplikasi lainnya. Komputer dengan kapasitas memori kecil dapat memulai menggunakan model kecil yang sudah dikuantisasi. Perangkat dengan kapasitas hardware lebih tinggi memiliki ruang lebih besar untuk LLM kompleks. Strategi seperti ini membantu menemukan konfigurasi ideal lebih cepat.
Jangan Hanya Melihat Besarnya Model ketika Memilih AI Lokal
Jumlah parameter memang memberikan gambaran mengenai kompleksitas model, tetapi tidak dapat dijadikan patokan tunggal. Model ringan yang dioptimalkan secara tepat dapat bekerja dengan baik untuk kebutuhan sehari hari.
Dalam mencari AI lokal yang tepat, pertimbangkan tujuan penggunaan seperti mengolah bahasa, pemrograman, mengolah informasi panjang, atau percakapan umum. Model yang dirancang untuk coding, misalnya, dapat lebih cocok untuk developer dibandingkan model general purpose tertentu. Pendekatan berbasis kebutuhan membuat TEKNOLOGI AI lebih efektif digunakan.
Model Terkuantisasi Membantu LLM Berjalan pada Hardware Lebih Ringan
Kuantisasi merupakan salah satu konsep penting bagi pengguna yang ingin menjalankan LLM secara lokal. Dengan kuantisasi, representasi bobot model dapat dioptimalkan untuk mengurangi ukuran, sehingga model lebih mudah dimuat pada perangkat konsumen.
Meski demikian, tingkat kuantisasi sebaiknya disesuaikan dengan kebutuhan karena konfigurasi yang terlalu ringan dapat membawa kompromi terhadap hasil. Pada tahap awal, format model yang masih mempertahankan kualitas memadai biasanya dapat memberikan pengalaman yang seimbang. Setelah memahami performanya, pengguna dapat mencoba konfigurasi lain.
CPU Tetap Bisa Menjalankan LLM tetapi GPU Membantu Mempercepat Inferensi
LLM lokal tidak selalu membutuhkan GPU khusus. Sejumlah TEKNOLOGI AI lokal memungkinkan pemrosesan menggunakan CPU. Cara tersebut dapat membuka akses AI lokal bagi lebih banyak perangkat, meskipun proses generasi token mungkin lebih lambat.
Jika GPU tersedia, sebagian komputasi AI dapat diakselerasi menggunakan kartu grafis. Hasilnya, respons dapat diproses dengan performa lebih tinggi. Namun, memori GPU masih menjadi batas penting, sehingga model besar belum tentu dapat dimuat sepenuhnya.
Runtime AI Lokal Menyederhanakan Proses Memasang dan Menjalankan Model
Sesudah menentukan ukuran model, langkah berikutnya adalah menentukan aplikasi inferensi. Perangkat lunak inferensi berfungsi untuk menjalankan file LLM serta memberikan cara berinteraksi dengan AI. Bagi pemula, aplikasi dengan pengaturan sederhana dapat membuat eksperimen lebih nyaman.
Pemula yang belum terbiasa dengan terminal dapat mencari software dengan pengelolaan model visual. Sementara itu, pengguna teknis dapat menggunakan layanan dengan API lokal agar lebih mudah diintegrasikan. Runtime yang paling sesuai bukan selalu TEKNOLOGI dengan konfigurasi paling luas, melainkan yang cocok dengan kemampuan perangkat.
Optimalkan Konfigurasi agar LLM Tidak Membebani Laptop
Ukuran model bukan satu satunya faktor dalam membuat inferensi berjalan nyaman. Jumlah informasi yang dipertahankan model juga dapat menambah beban komputasi. Semakin panjang konteks yang digunakan, sistem dapat menggunakan sumber daya lebih besar.
Pada perangkat dengan hardware terbatas, gunakan context window sesuai kebutuhan dan sisakan sumber daya untuk runtime AI. Amati beban sistem, memori GPU, serta suhu CPU dan GPU. Apabila respons menjadi sangat lambat, kurangi panjang konteks hingga performa kembali stabil.
Kesimpulan, Keseimbangan Model dan Hardware Menjadi Kunci AI Lokal
Menjalankan LLM offline tidak harus membutuhkan perangkat paling mahal. Kunci utamanya adalah mengetahui kapasitas hardware, kemudian menentukan LLM secara realistis. Sumber daya perangkat, format model, serta runtime dan context window bersama sama memengaruhi performa AI lokal.
Untuk pengguna yang baru mencoba, mulailah dengan model yang ringan, kemudian coba model lebih besar setelah memahami performa. Dari pengalaman Anda, apakah model bahasa yang berjalan langsung di perangkat akan menjadi semakin populer seiring hardware konsumen semakin kuat? Sampaikan pengalaman Anda mengenai perkembangan AI offline dan ikuti informasi selanjutnya untuk mengetahui cara mengoptimalkan LLM.