Microsoft Siapkan MAI Code 1.1 Flash untuk Menjalankan Coding AI Lokal di Windows

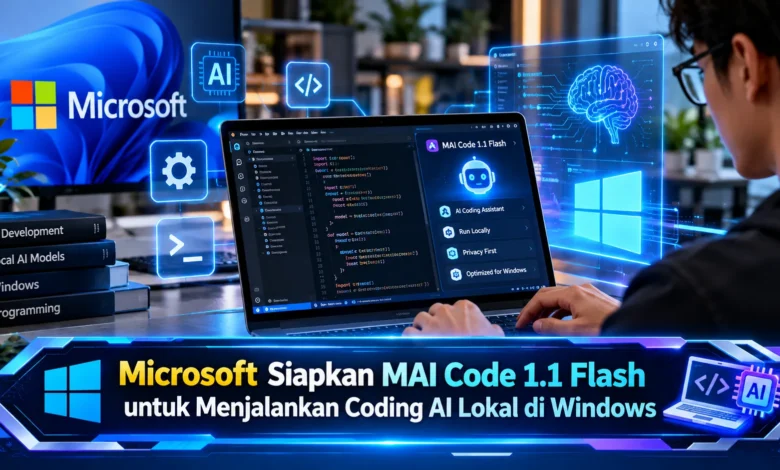
Microsoft memperkenalkan langkah baru dalam pengembangan teknologi kecerdasan buatan melalui optimalisasi MAI Code 1.1 Flash agar dapat dijalankan secara lokal pada komputer Windows. Dalam pengumuman 7 Oktober 2026, perusahaan menjelaskan bahwa model AI khusus pemrograman tersebut menggunakan teknik kompresi canggih untuk mengurangi kebutuhan memori tanpa mengorbankan sebagian besar kemampuan coding. Inovasi ini menjadi bagian dari strategi Microsoft menghadirkan pengalaman pengembangan perangkat lunak yang lebih cepat, responsif, dan tidak selalu bergantung pada cloud. Dengan dukungan perangkat keras yang memadai, pengembang berpeluang menjalankan model AI berkemampuan tinggi langsung dari komputer pribadi sambil mempertahankan kendali lebih besar atas proses pengolahan data.
Microsoft Memperluas Kemampuan AI Lokal melalui MAI Code 1.1 Flash
Transformasi TEKNOLOGI AI modern membawa perubahan terhadap cara pengembang menulis program. Dengan menghadirkan pengembangan MAI Code 1.1 Flash, Microsoft berupaya membawa asisten pengembangan perangkat lunak ke komputer Windows lokal. Pendekatan tersebut dirancang untuk membatasi ketergantungan terhadap pemrosesan cloud. Pada lingkungan pengembangan, teknologi tersebut memungkinkan bantuan penulisan kode tanpa mengandalkan server jarak jauh pada seluruh permintaan. Kemampuan ini memberikan pilihan menarik bagi tim rekayasa perangkat lunak yang membutuhkan respons cepat. Melalui pendekatan tersebut, Microsoft menunjukkan strategi pemrosesan lokal.
Sistem AI pemrograman Microsoft hadir dalam bentuk model mixture of experts dengan total parameter mencapai 137 miliar. Walaupun jumlah parameternya tinggi, jumlah parameter aktifnya sekitar 6,8 miliar dalam setiap proses inferensi. Desain MoE tersebut dirancang agar penggunaan komputasi lebih terarah. Berbeda dari arsitektur yang menggunakan seluruh parameter pada setiap token, model MoE memilih komponen aktif berdasarkan kebutuhan tugas. Namun demikian, kapasitas RAM yang diperlukan masih bergantung pada pengelolaan parameter. Karena itu, penyederhanaan representasi bobot berperan besar untuk mengurangi beban memori perangkat.
Cara Microsoft Mengurangi Kebutuhan Memori Model Coding AI
Salah satu teknik utama Microsoft adalah penurunan presisi representasi angka untuk mengurangi ukuran model. Dalam sistem AI, informasi numerik model dicatat menggunakan representasi bilangan dengan ukuran berbeda. Apabila setiap bobot menggunakan lebih banyak bit, kebutuhan penyimpanan dapat meningkat. Dalam optimalisasi lokal, Microsoft menerapkan representasi bobot berpresisi rendah pada MAI Code 1.1 Flash. Pendekatan tersebut berhasil menekan beban penyimpanan bobot sekitar empat perlima dibandingkan versi model tanpa kompresi setara. Hasilnya, model terkompresi menempati sekitar 53 gigabyte, sehingga lebih memungkinkan pemrosesan melalui PC berkinerja tinggi.
Kendati representasi bobot menjadi lebih ringkas, Microsoft tetap memperhatikan kemampuan menyelesaikan tugas coding. Hal ini penting karena perubahan karakter tertentu berpotensi menghasilkan nama variabel yang salah. Berdasarkan hasil benchmark perusahaan, MAI Code dengan presisi rendah mencatat hasil 70,8 persen di SWE-bench Verified, sedangkan model tanpa kuantisasi setara mencapai 72,6 persen. Jarak performa tersebut memberikan indikasi bahwa penurunan presisi tidak selalu menghilangkan kualitas pemrograman. Namun demikian, skor tersebut tidak menjamin kode selalu benar. Dengan mempertimbangkan keterbatasan ini, pengujian otomatis tetap dibutuhkan sebelum hasil AI digunakan dalam produksi.
MAI Code 1.1 Flash Mendukung Coding Lokal dengan Konteks Besar
Tidak hanya menawarkan efisiensi penyimpanan, MAI Code 1.1 Flash tetap mendukung context window sebesar 256.000 token pada model yang berjalan di komputer. Kemampuan pemrosesan tersebut mendukung analisis terhadap dokumentasi teknis berukuran besar. Dalam pengembangan perangkat lunak, programmer perlu memahami ketergantungan modul. Melalui kapasitas input yang luas, asisten dapat mempertimbangkan bagian proyek yang saling berkaitan. Fungsi ini dapat mendukung penelusuran bug yang membutuhkan informasi dari berbagai bagian proyek. Namun demikian, pengembang tetap perlu memilih informasi yang relevan.
Pada proses inferensi di perangkat, jumlah token yang diproses memiliki hubungan dengan kebutuhan komputasi. Microsoft melaporkan, kebutuhan memori tertinggi mencapai sekitar 75,5 gigabyte pada pemrosesan konteks maksimal 256 ribu token. Angka tersebut menegaskan bahwa pemrosesan juga memerlukan ruang kerja tambahan. Di samping penggunaan memori, perusahaan mencatat throughput input mencapai 923,5 token per detik pada panjang input 64 ribu token. Untuk ukuran konteks lebih panjang, kecepatannya sekitar 769,8 token per detik ketika jumlah masukan sebesar 128 ribu token. Namun, hasil benchmark menggunakan konfigurasi khusus sehingga performa nyata bergantung pada perangkat dan aplikasi.
Teknologi Prediksi Token untuk Mengurangi Latensi AI Lokal
Di luar teknik kompresi bobot, Microsoft mengembangkan metode decoding spekulatif untuk mengurangi waktu tunggu inferensi. Pendekatan tersebut menggunakan model atau komponen penduga yang lebih dahulu mengusulkan sejumlah token berikutnya. Kemudian, model utama memverifikasi blok token yang diajukan sebelum melanjutkan pembentukan respons. Berkat metode prediksi dan pemeriksaan, generasi respons berpotensi berlangsung lebih cepat. Kemampuan ini menjadi relevan untuk aplikasi pengembangan perangkat lunak yang membutuhkan respons singkat. Meski menawarkan percepatan, metode ini memerlukan sumber daya untuk model penduga, sehingga optimalisasi memerlukan keseimbangan sumber daya.
Ketika programmer menggunakan asisten AI, waktu keluaran kode dapat menentukan kenyamanan interaksi. Ketika respons memerlukan jeda besar, aktivitas coding dapat terhenti sementara. Ketika hasil tersedia lebih cepat, programmer dapat segera memeriksa saran perbaikan. Menurut informasi pengembang, MAI Code 1.1 Flash dalam GitHub Copilot menunjukkan peningkatan kecepatan token sebesar seperempat dibandingkan versi sebelumnya. Di samping peningkatan kecepatan, kebutuhan token per tugas berkurang sekitar seperempat untuk menuntaskan tugas dalam pengujian. Meski demikian, hasil efisiensi layanan cloud tidak otomatis sama dengan kecepatan lokal. Karena itu, pengembang perlu menguji performa pada proyek sendiri.
Integrasi Model Coding Microsoft dengan Ekosistem Developer Windows
Komponen strategis teknologi ini adalah penggunaan sistem coding terbaru melalui GitHub Copilot. Ekosistem pengembangan tersebut menjadi pilihan bagi sejumlah tim perangkat lunak untuk menulis dan memperbaiki kode. Berdasarkan pengumuman perusahaan, MAI Code 1.1 Flash menjadi bagian dari layanan coding AI GitHub Copilot. Tidak terbatas pada pemrosesan server, Microsoft juga menyiapkan pemrosesan on-device. Akses eksperimental melalui aplikasi GitHub Copilot ditargetkan tersedia sebelum bulan Oktober 2026 berakhir. Berkat pengembangan lintas aplikasi, programmer akan memiliki pilihan pemrosesan berdasarkan kebutuhan melalui alat pengembangan sehari-hari. Meski rencana akses telah diumumkan, akses awal mungkin memiliki batasan.
Microsoft merekomendasikan sistem dengan kapasitas RAM melebihi 120GB untuk memperoleh performa on-device yang optimal. Persyaratan performa tersebut memberikan gambaran bahwa tidak semua PC dapat menjalankan model dengan nyaman. Perangkat seperti Surface Laptop Ultra termasuk lingkungan perangkat yang dituju untuk pengembangan AI lokal. Microsoft juga menjelaskan bahwa inferensi yang berjalan di perangkat tidak dikenakan biaya inferensi per permintaan. Meski panggilan lokal tidak ditagih seperti cloud, perusahaan harus menghitung pemeliharaan infrastruktur, serta ketentuan langganan perangkat lunak. Berdasarkan kondisi tersebut, efisiensi biaya harus dinilai secara menyeluruh.
Manfaat dan Tantangan Coding AI Lokal bagi Pengembang Windows
Keuntungan penting dari penggunaan asisten AI tanpa cloud adalah kontrol lebih besar atas data proyek. Dalam lingkungan perusahaan, konfigurasi aplikasi dapat mengandung rahasia perusahaan. Dengan pemrosesan di perangkat, sebagian pekerjaan dapat diselesaikan tanpa mengirim kode ke layanan jarak jauh. Strategi komputasi lokal berpotensi mendukung mengurangi ketergantungan koneksi. Meski menawarkan keuntungan privasi, risiko digital tidak sepenuhnya hilang. Ekstensi perangkat lunak tetap dapat memiliki koneksi jaringan. Karena itu, administrator sebaiknya mengevaluasi konfigurasi sebelum membuka dokumen internal.
Di sisi lain, penerapan coding on-device juga menghadapi beberapa kebutuhan operasional. Kapasitas parameter yang tinggi menjadi faktor pembatas kemudahan penggunaan pada laptop umum. Selain itu, hasil pemrograman AI harus melalui validasi sebelum digunakan dalam layanan aktif. Asisten coding otomatis dapat menghasilkan kode yang tidak sesuai konteks. Dengan demikian, proses code review harus dipertahankan meskipun model dapat mempercepat pekerjaan. Penerapan teknologi secara bertanggung jawab menyatukan efisiensi otomatisasi dengan pengawasan manusia agar kualitas program tetap terjaga.
Kesimpulan: MAI Code 1.1 Flash Membawa Coding AI ke Komputer Windows
Pengembangan MAI Code 1.1 Flash menjadi perkembangan penting dalam dunia TEKNOLOGI kecerdasan buatan. Dengan memanfaatkan teknik penyederhanaan representasi model, metode prediksi token, dan arsitektur mixture of experts, Microsoft mampu mengurangi ukuran pemrosesan lokal sambil mempertahankan kemampuan coding yang kompetitif. Peluang memanfaatkan model pada komputer lokal memberikan manfaat potensial bagi programmer profesional. Namun demikian, kebutuhan memori yang besar tetap membatasi sebagian pengguna. Berkat strategi penggunaan yang terencana, pengembang berpeluang menentukan pekerjaan yang sesuai untuk AI on-device. Dari sudut pandang Anda, apakah model AI besar layak dijalankan langsung pada laptop profesional? Silakan bagikan pendapat Anda mengenai perkembangan MAI Code 1.1 Flash.